Adaptive Sampling: Giảm 99% dữ liệu Distributed Tracing mà không mất khả năng quan sát
Cách chúng tôi mở rộng Distributed Tracing trên hàng nghìn máy chủ Microsoft 365 mà không bị ngập trong dữ liệu, đồng thời không đánh đổi độ tin cậy của Active Monitoring.
Tuyên bố miễn trừ: Tên các hệ thống trong bài đã được thay đổi để tránh tiết lộ thông tin mật. Mọi con số đều chính xác.
Trong hai năm qua, nhóm của tôi tại Microsoft đã tích hợp Distributed Tracing (DT) vào hầu hết các microservice quan trọng của Substrate, nền tảng vận hành Microsoft 365. DT là công cụ chúng tôi tìm đến mỗi khi một API gặp sự cố: nó cho phép xác định chính xác node đã gây ra lỗi và chỉ ra những thành phần đang kéo độ trễ lên.
DT kết hợp rất tự nhiên với một hệ thống do nhóm đối tác vận hành — Active Monitoring — một đội probe tổng hợp liên tục gọi vào các dịch vụ nội bộ và máy chủ vật lý để đảm bảo mọi thứ luôn khỏe mạnh. Khi một probe thất bại, một trace là khác biệt giữa “có chỗ nào đó đang hỏng” và “lời gọi downstream cụ thể này đã hết thời gian chờ trên chiếc máy cụ thể này.”
Bài toán mở rộng quy mô#
Microsoft 365 chạy trên hàng trăm nghìn máy chủ vật lý trải khắp thế giới. Chỉ riêng Active Monitoring đã tạo ra khoảng 78 triệu request mỗi giờ ở quy mô đó. Mỗi request được lấy mẫu đều tạo ra một trace, và mỗi trace mang theo hàng chục span qua nửa tá dịch vụ. Tổng khối lượng đơn giản là quá lớn để backend DT của chúng tôi tiếp nhận, lưu trữ và truy vấn với chi phí chấp nhận được.
Vì vậy chúng tôi cần lấy mẫu (sampling). Điểm khó là ràng buộc mà Active Monitoring đặt ra:
Nếu một request tổng hợp thất bại, chúng tôi bắt buộc phải có trace của nó. Không có ngoại lệ.
Mất trace thì cảnh báo trở nên vô dụng — on-call bị gọi dậy mà không có con đường nào để tìm ra nguyên nhân gốc. Điều đó còn tệ hơn là không có cảnh báo.
Vậy thử thách thật sự không phải là “giảm dữ liệu”. Mà là: giảm dữ liệu thật mạnh tay, nhưng không bao giờ bỏ sót một request không khỏe mạnh.
Vì sao các sampler có sẵn không phù hợp#
OpenTelemetry cung cấp hai nhóm chiến lược lấy mẫu. Chúng tôi đã xem xét kỹ cả hai.
Head-based: Ratio Sampler#
Head-based sampling quyết định giữ hay bỏ một trace ngay khi nó bắt đầu, trước khi có bất kỳ span nào được ghi nhận. Biến thể phổ biến nhất là ratio sampler: giữ N% số trace, bỏ phần còn lại.
Ưu điểm:
- Rẻ. Quyết định được đưa ra cục bộ và tức thì.
- Khối lượng dữ liệu dự đoán được. Chọn 1% thì bạn nhận đúng 1%.
Nhược điểm (với trường hợp của chúng tôi):
- Nó mù về kết quả. Một request không khỏe mạnh có cơ hội được giữ lại ngang với một request khỏe mạnh.
- Ở quy mô toàn cầu, tỷ lệ lỗi rất nhỏ — chỉ một phần nhỏ của một phần trăm. Bất kỳ tỷ lệ nào đủ thấp để vừa ngân sách dữ liệu của chúng tôi cũng sẽ âm thầm vứt bỏ phần lớn những lỗi mà chúng tôi sinh ra để điều tra.
Tail-based Sampler#
Tail-based sampling đưa ra quyết định sau khi trace kết thúc, khi đã biết kết quả. Về lý thuyết nó hoàn hảo: giữ 100% trace thất bại, bỏ 100% trace thành công.
Trên thực tế, nó có hai vấn đề hóa ra là điểm chết với chúng tôi:
- Bạn phải đệm mọi span của mọi trace cho đến khi có quyết định. Bản thân bộ đệm đó đã là một chi phí lưu trữ và bộ nhớ khổng lồ — bạn chỉ chuyển vấn đề đi chỗ khác chứ chưa giải quyết nó. Ở khối lượng của chúng tôi, bộ đệm “tạm thời” sẽ lớn hơn cả backend mà chúng tôi đang cố bảo vệ.
- Bạn phải biết trace kết thúc ở đâu. Tail-based sampling cần một “cái đuôi” — span cuối cùng — để kích hoạt quyết định. Microsoft 365 là một đồ thị dịch vụ rộng lớn và liên tục thay đổi. Không có một cái đuôi chuẩn duy nhất. Dịch vụ được thêm vào, đồ thị lời gọi dịch chuyển, các nhánh fan-out bất đồng bộ khiến “điểm kết thúc” trở nên mơ hồ. Bất kỳ heuristic nào chúng tôi chọn cũng sẽ lỗi thời trong vòng một quý.
Hình hài của một lời giải tốt hơn: adaptive sampling#
Trong lúc đào sâu các thảo luận của OpenTelemetry và các buổi nói chuyện tại hội nghị, tôi liên tục gặp thuật ngữ adaptive sampling — ý tưởng rằng chính cấu hình của sampler nên thay đổi theo thời gian để phản ứng với những gì hệ thống đang làm. Có những gợi ý, bản phác thảo và các mô tả dài một đoạn, nhưng không có thiết kế nào đã được kiểm chứng thực chiến để chúng tôi lấy về dùng.
Vì vậy chúng tôi tự thiết kế. Nhận định cốt lõi nhỏ nhưng mạnh:
Một head-based ratio sampler thì nhanh và rẻ. Một tail-based sampler thì biết kết quả. Nếu chúng ta giữ head-based sampler, nhưng để kết quả của vài phút trước quyết định tỷ lệ của nó thì sao?
Chúng tôi chia công việc cho hai thành phần mới:
AdaptiveSamplerlà sampler tùy biến của chúng tôi, áp dụng cho Active Monitoring. Nó vẫn là head-based — quyết định diễn ra ngay khi trace bắt đầu, không cần đệm. Nhưng thay vì một tỷ lệ cố định duy nhất, nó giữ một bản đồ tỷ lệ theo từng server ([{serverA: 1.0}, {serverB: 0.1}, ...]) do Config System đẩy xuống. Khi một request đến server X, nó tra tỷ lệ của X rồi tung một số ngẫu nhiên: SAMPLED với xác suất đó, ngược lại DROP.AdaptiveSamplerWorkerlà bộ điều khiển. Cứ 5 phút, nó đọc kết quả Active Monitoring trong 5 phút gần nhất từ MDM, chọn ra những server có ít nhất một request không khỏe mạnh (các server hot), rồi ghi một bản đồ tỷ lệ mới vào Config System: 100% cho các server hot, 10% cho tất cả server còn lại.
Sau đó Config System lan truyền bản đồ này tới mọi server Active Monitoring, nơi mỗi AdaptiveSampler nhận thay đổi và điều chỉnh hành vi ở request kế tiếp.
Cái giá phải trả là độ trễ thời gian. Nếu một server lỗi lần đầu tiên tại thời điểm T, chúng tôi sẽ không lấy mẫu nó ở mức 100% cho đến khi lần chạy kế tiếp của worker tính ra bản đồ và Config System đẩy nó xuống. Câu hỏi trở thành: độ trễ đó là bao lâu, và có chấp nhận được không?
Vì sao cách này hiệu quả ở Microsoft 365: hạ tầng sẵn có#
Câu hỏi về độ trễ là chỗ thiết kế gặp may. Microsoft 365 vốn đã có hai mảnh hạ tầng mà chúng tôi có thể dựa vào:
Active Monitoring → MDM (kho metrics của chúng tôi). Kết quả probe đi vào MDM với độ trễ tối đa ~2 phút.
Config System → mọi server. Các thay đổi cấu hình lan đến mọi server trên toàn thế giới trong vòng ~5 phút.
Ghép chúng lại:
- Một request không khỏe mạnh xảy ra tại thời điểm T.
- Kết quả của nó có thể truy vấn được trong MDM chậm nhất vào T + 2 phút.
AdaptiveSamplerWorkerđọc MDM, tính tỷ lệ mới và ghi bản đồ cập nhật vào Config System.- Cấu hình mới đến server bị ảnh hưởng chậm nhất vào T + 7 phút.
- Server đó duy trì mức lấy mẫu 100% qua cửa sổ quyết định kế tiếp — chậm nhất đến T + 12 phút.
Vậy trong trường hợp xấu nhất, chỉ một request lỗi cũng cho chúng tôi một cửa sổ trace đầy đủ độ phân giải kéo dài 5–10 phút trên server gặp vấn đề, bắt đầu khoảng 7 phút sau lỗi. Đủ dài để bắt được lỗi kế tiếp nếu sự cố vẫn còn tiếp diễn — chính là trường hợp quan trọng nhất với on-call.
Thiết kế tổng quan#
Bốn thành phần, một vòng lặp:
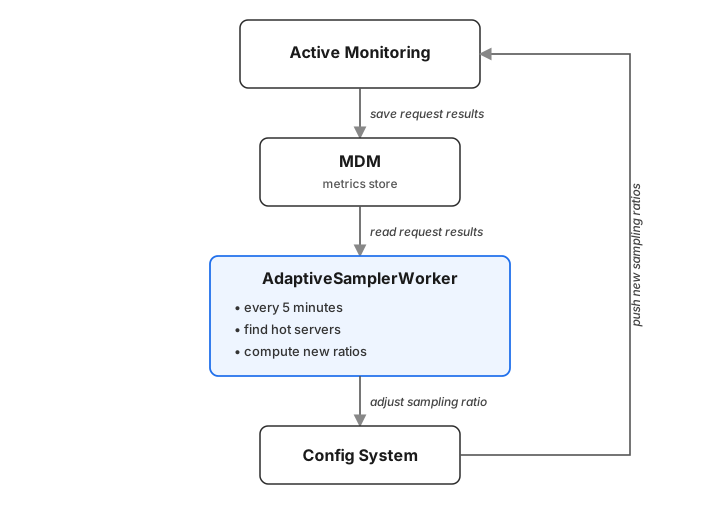
Thành phần mới duy nhất là AdaptiveSampler (sampler tùy biến, kế thừa lớp cơ sở của OpenTelemetry) và AdaptiveSamplerWorker (Azure Function, kích hoạt mỗi 5 phút). MDM, Config System và bản thân Active Monitoring đã có sẵn và do các nhóm khác duy trì. Chúng tôi không xây một nền tảng lấy mẫu — chúng tôi viết một sampler tùy biến nhỏ và một bộ điều khiển phản ứng để điều khiển nó.
Một vài lưu ý về bộ điều khiển mà sơ đồ không cho thấy rõ:
- Quyết định idempotent. Mỗi lần chạy tính lại toàn bộ tập server hot từ đầu. Không có trạng thái tăng dần nào có thể bị hỏng; nếu worker sập rồi khởi động lại, lần chạy kế tiếp vẫn đúng.
- Không hysteresis, có chủ ý. Một server hot tại T và yên tĩnh tại T+5 sẽ quay về 10%. Chúng tôi từng cân nhắc một cơ chế cooldown (“giữ hot thêm hai chu kỳ sau khi phục hồi”) và quyết định không làm — lượng dữ liệu thêm không đáng với độ phức tạp tăng thêm, và 5 phút đệm ở lần lỗi kế tiếp đã là đủ.
- Hai tỷ lệ, không phải một đường cong. Chúng tôi từng thử thang trượt (lỗi càng nhiều → tỷ lệ càng cao) rồi bỏ. Nhị phân 100/10 dễ suy luận hơn, dễ gỡ lỗi hơn, và phần dữ liệu tiết kiệm được chủ yếu đến từ kích thước của phần fleet yên tĩnh, chứ không phải từ việc tinh chỉnh phần ồn ào.
Kết quả#
Sau khi triển khai:
- Giảm ~99% số trace khỏe mạnh mà backend DT tiếp nhận.
- Giảm 0% số trace không khỏe mạnh Active Monitoring thu được trong cửa sổ của nó.
Trong Test ring, nơi lưu lượng không khỏe mạnh cao hơn do chủ ý thiết kế, mức tiết kiệm khá khiêm tốn — không có nhiều lưu lượng khỏe mạnh để sampler loại bỏ:
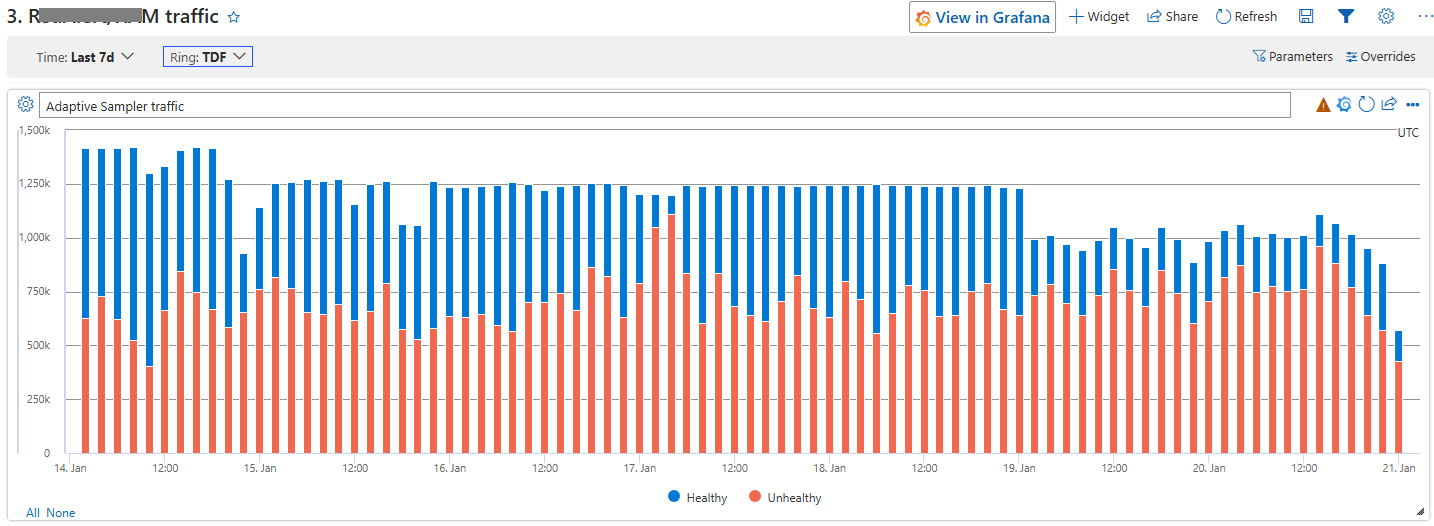 Test ring: trace khỏe mạnh chỉ giảm khiêm tốn — phần lớn lưu lượng vốn không khỏe mạnh theo thiết kế, nên sampler không có nhiều thứ để bỏ.
Trong Global ring, nơi fleet gần như hoàn toàn khỏe mạnh, mức giảm là không thể nhầm lẫn. Hãy nhìn nơi đợt triển khai đáp xuống:
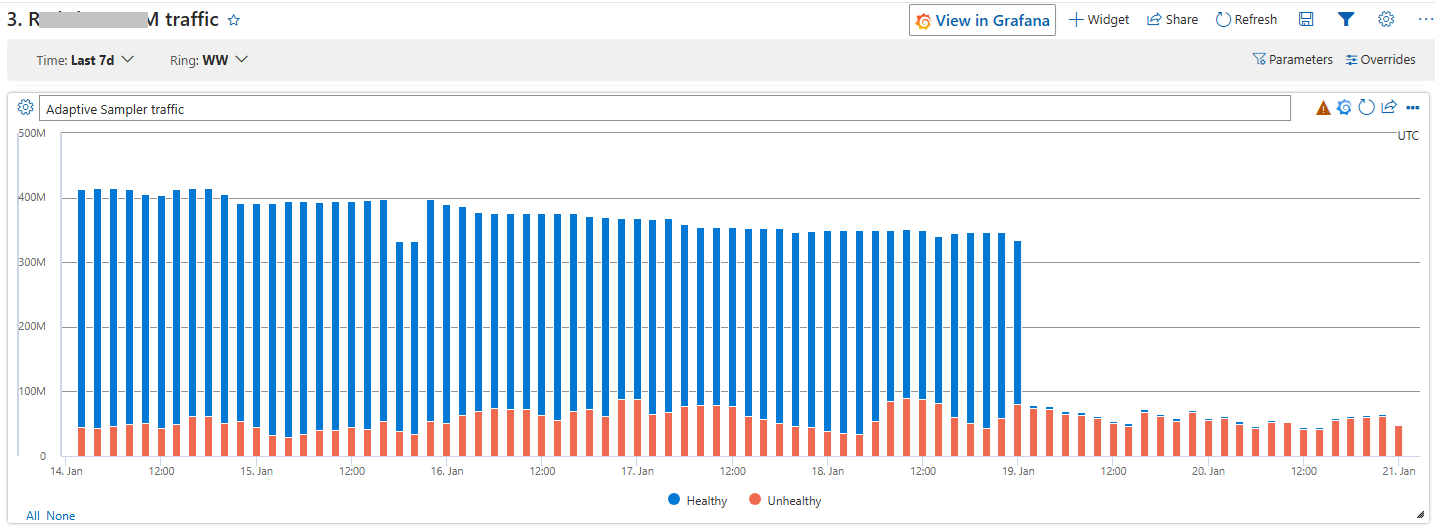 Global ring: trace khỏe mạnh rơi thẳng đứng ngay khi AdaptiveSampler bắt đầu hoạt động, trong khi lưu lượng không khỏe mạnh gần như không thay đổi.
Điều rút ra#
Vài điều tôi muốn chia sẻ với bất kỳ ai gặp bài toán tương tự:
- Đừng chọn một sampler. Hãy chọn một vòng điều khiển. Head-based hay tail-based là một thế lưỡng phân sai lầm nếu bạn có thể đổi cấu hình lấy mẫu trong vài phút. Không gian thiết kế thú vị nằm ở tín hiệu nào điều khiển việc thay đổi cấu hình.
- Tận dụng ngân sách độ trễ bạn đã có. Thiết kế của chúng tôi chỉ hoạt động vì MDM và Config System vốn đã nhanh. Nếu chúng là các hệ thống batch chạy theo giờ, cách này sẽ sụp đổ và bạn quay về với tail-based cùng mọi vấn đề của nó. Hãy biết nhịp đồng hồ của hạ tầng hiện có trước khi thiết kế bên trên nó.
- “Có mất mát nhưng đúng hướng” thắng “không mất mát nhưng không đủ tiền.” Chúng tôi chấp nhận mất một lỗi thoáng qua xuất hiện lần đầu. Chúng tôi không chấp nhận mất một lỗi kéo dài. Xác định chính xác mức mất mát chấp nhận được hữu ích hơn việc đuổi theo con số không.
- Adaptive sampling còn thiếu tài liệu. Ý tưởng này lưu hành trong các buổi nói chuyện tại hội nghị và các issue của OTel, nhưng khi bắt đầu tôi không tìm được bài viết thực tế nào. Nếu bạn đang thiết kế một hệ thống như vậy, lời giải có lẽ đơn giản hơn những gì tài liệu khiến nó trông như thế — của chúng tôi chỉ gồm vài trăm dòng code cho worker cộng với một câu truy vấn SQL vào MDM.
Nếu bạn đang nhìn hóa đơn DT không vừa ngân sách và một yêu cầu độ tin cậy không chịu nhượng bộ, mẫu thiết kế này đáng để thử.